
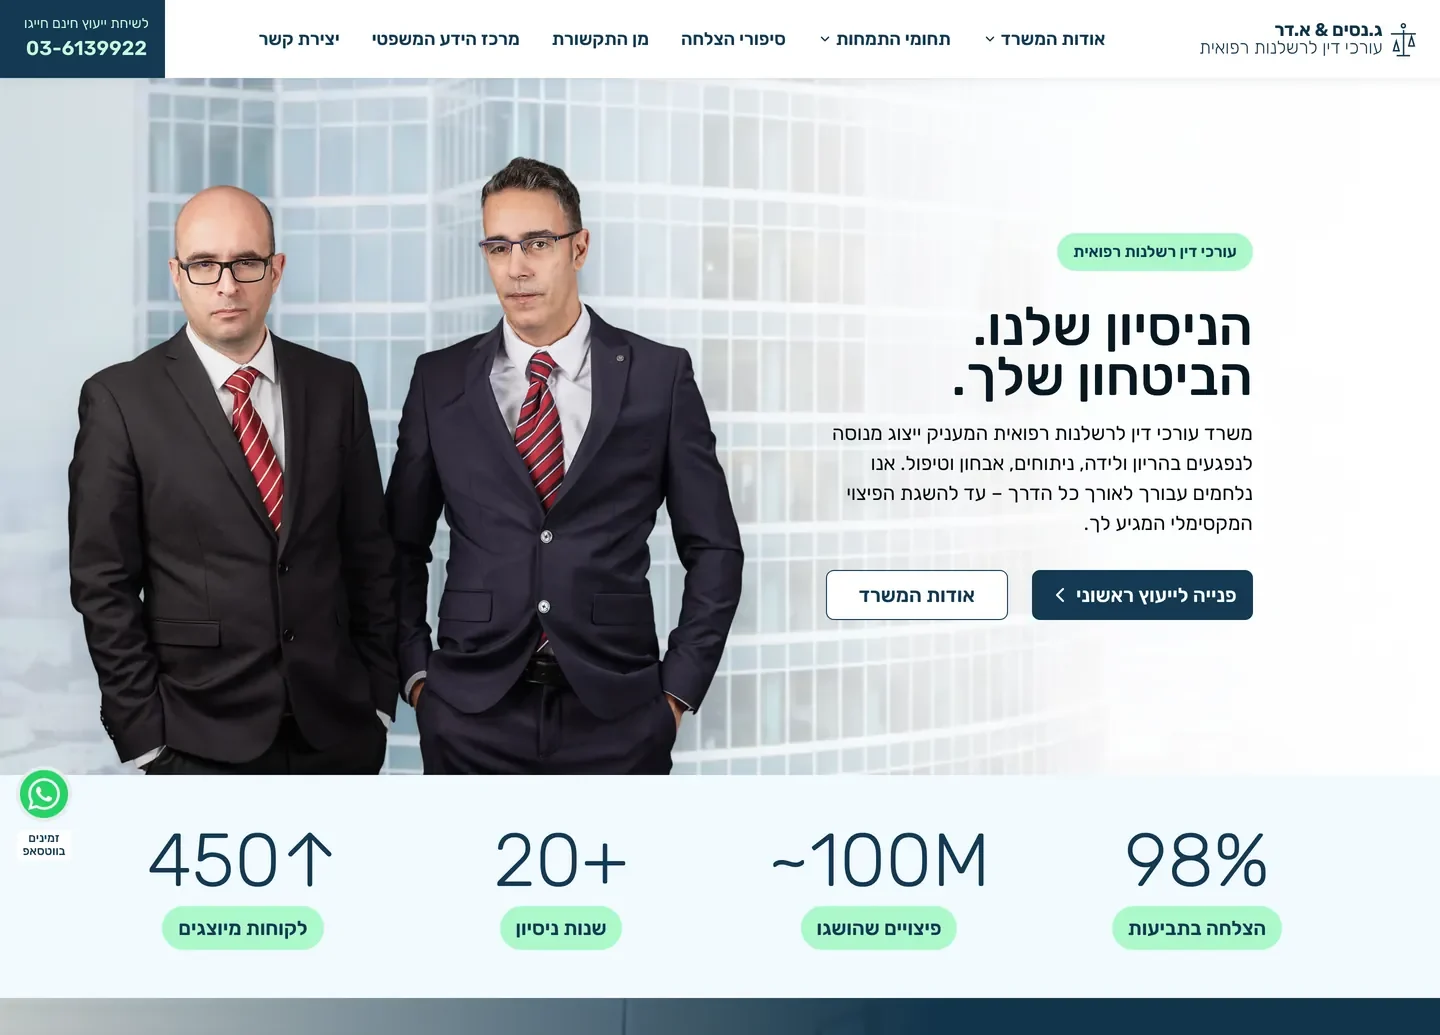
GN Law הוא משרד עורכי דין לרשלנות רפואית ברמת גן. שני שותפים, עשרים שנות פרקטיקה, וכשלוש מאות מאמרים על טעויות באבחון, נזקי לידה ורשלנות בניתוחים.
מאמרים אלו הם השיווק של המשרד. לכתוב אותם לוקח עשור. להרוס אותם אפשר באחר צהריים אחד של חוסר תשומת לב.
האתר הישן שלהם רץ על תבנית Bootstrap עם 73 קבצי PHP, שלוש ספריות אנימציה ו-22 תוספים פעילים. הוא שלח 2.5 MB ב-125 בקשות רק כדי להציג את עמוד הבית.
בניתי אותו מחדש על בסיס קובץ Figma. לא כתמונת רפרנס כללית, כמו שרוב ההעברות מעיצוב לקוד מתנהלות בפועל, אלא כמקור האמת, בקריאה node אחרי node דרך ה-Figma MCP. אחר כך העברתי פנימה את כל 301 המאמרים בלי לאבד מילה אחת.
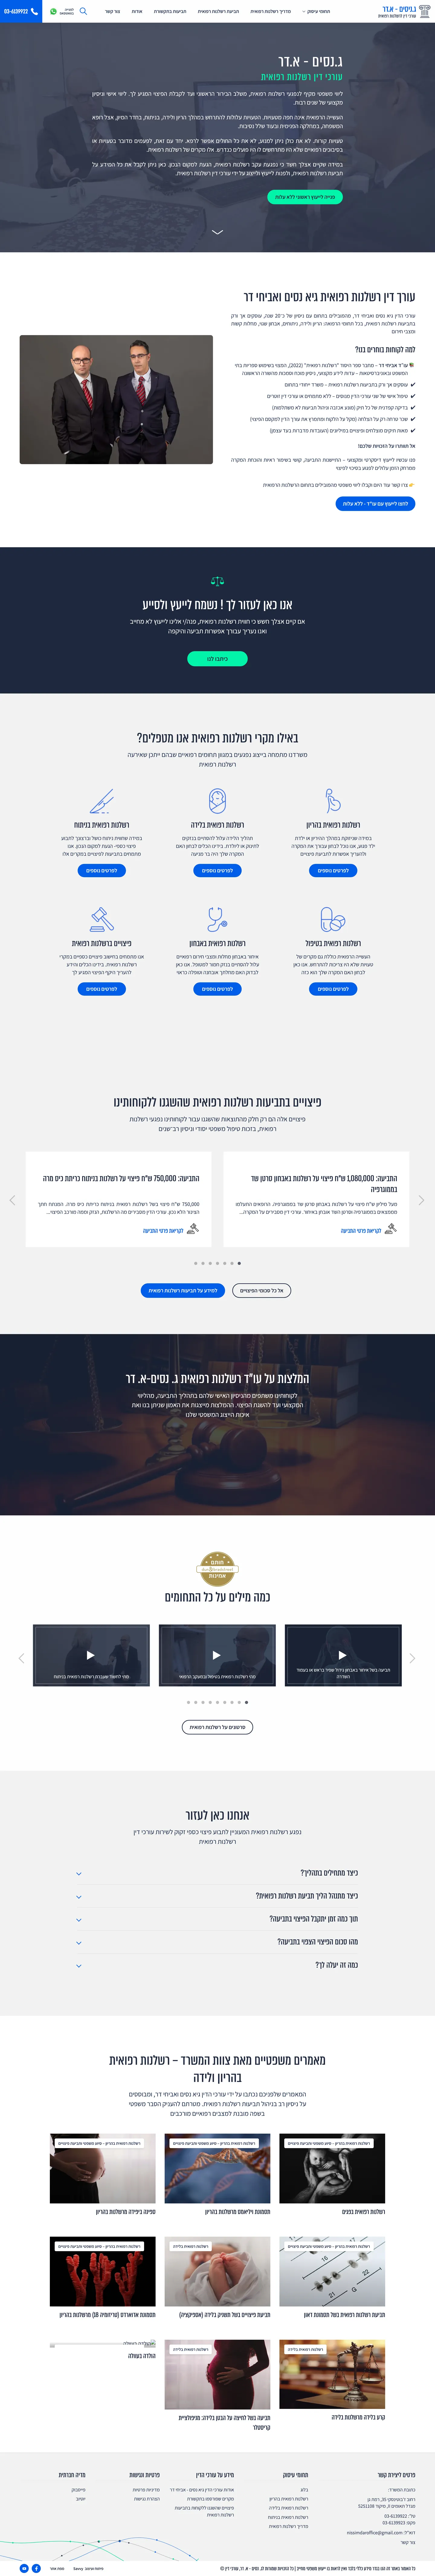
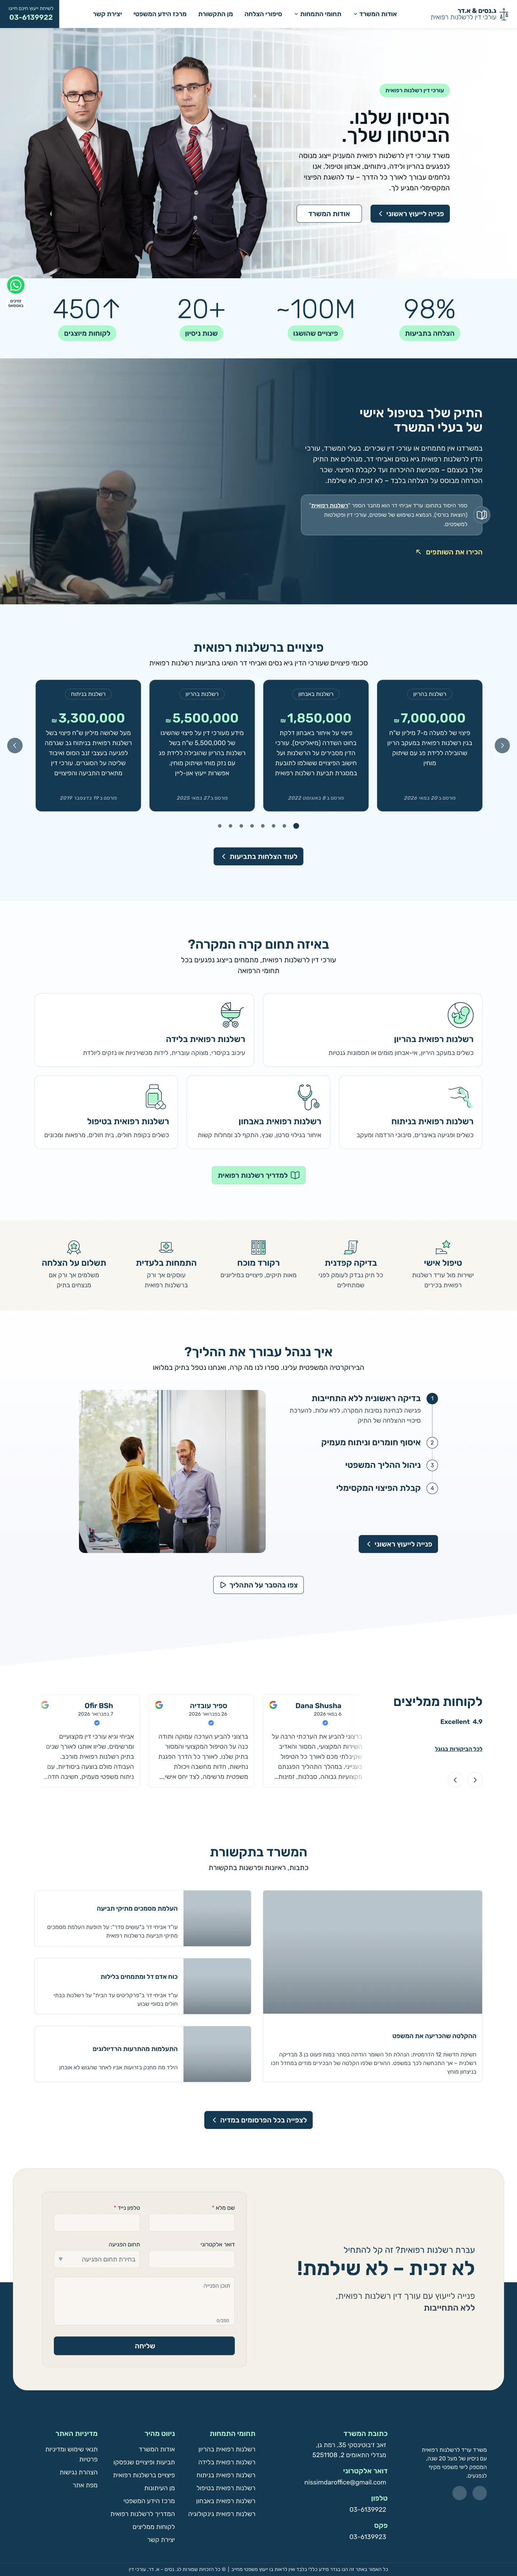
מה המשרד קיבל
- אתר שהוא שלהם. גם התבנית הישנה נבנתה במיוחד עבורם, אז זה לא סיפור של תבנית מותאמת מול תבנית מוכנה. היא פשוט הצטברה לאורך שנים, 73 קבצי PHP ו-22 תוספים, וגוף המאמרים ישב בשדה ACF ולא בפוסטים עצמם. בחדשה כל שורת CSS ניתנת למעקב עד node בקובץ ה-Figma של המשרד, וכל סקשן עד בריף כתוב. כתבתי את הטיעון המלא לטובת תבנית מותאמת במקום אחר.
- התוכן שלהם, שלם. כל 301 המאמרים אומתו מילה במילה מול האתר הישן, לא רק בדגימה.
- עמודים שהם יכולים לערוך. תחומי ההתמחות, סיפורי ההצלחה, הביוגרפיות של השותפים ופרטי המשרד הם היום שדות. במסך אחד יושבים הכתובת, הטלפון ושעות הפעילות, ועריכה שלו מעדכנת בבת אחת את עמוד יצירת הקשר, את הפוטר ואת הנתונים המובנים.
- חמישית מהמשקל. המספרים למטה.
שמירה על התוכן שלם חשובה יותר משנדמה. המשרד מדורג על ״רשלנות רפואית באבחון״ כי מישהו כתב מאמר מוקפד על טעויות באבחון ב-2019, והדירוג הזה שייך למאמר, לא לאתר. אם פסקה אובדת בהעברה, או משתנה בשקט, עשרים שנות דירוגים הולכות איתה.
לפני ואחרי, במספרים
מדדתי את שני האתרים על אותה מכונה, באותו session, אחד אחרי השני, עם אותו סקריפט: Lighthouse בפרופיל מובייל, שלוש הרצות לכל צד, ולקחתי את החציון.
אלו מספרי מעבדה ולא נתוני שדה. מה שהופך אותם לראויים לפרסום הוא הסימטריה, כי אף צד לא קיבל cache חם או הזדמנות שנייה.
משקל עמוד, מובייל
2,576 KB
430 KB
עמוד הבית, חציון של 3 הרצות מעבדה
בקשות
125
32
JavaScript
29 קבצים, 1,580 KB
3 קבצים, 200 KB
בלי jQuery, בלי Bootstrap
תמונות
47 קבצים, 790 KB
20 קבצים, 121 KB
AVIF ו-WebP, בגודל נכון ועם lazy
Lighthouse, מובייל
58
96
נגישות: מ-76 ל-100
LCP
18.2 שניות
2.8 שניות
מעבדה, אותה מכונה ואותו session לשני הצדדים
מאמרים
143 בלי גוף מאמר
301 מתוך 301 הועברו
0 מילים אבדו, 0 הומצאו
לקרוא את קובץ העיצוב כמו שצריך
קובץ Figma הוא מקור אמת רק אם מתייחסים אליו ככזה. בדרך כלל מסתכלים על העיצוב, מתרשמים, ואז בונים לפי ההתרשמות ולא לפי הקובץ.
קריאה נכונה שלו פירושה למשוך את נתוני ה-node עצמם ולכתוב את מה שכתוב שם, לא את מה שאתם זוכרים שראיתם. שלושה כללים הפכו את זה לאמין, ואת כולם למדתי בדרך הקשה.
קובץ אחד בכל רגע נתון
ה-Figma Dev Mode MCP מפענח מזהי node מול המסמך שנמצא בפוקוס באפליקציית הדסקטופ. היו שני עותקים של העיצוב הזה, ולשניהם היו מזהי node זהים.
מכיוון שהמזהים תואמים, קריאה מול הקובץ הלא נכון מצליחה בשקט ומחזירה את העיצוב הלא נכון. אל תחליפו פוקוס ב-Figma. אם קריאות מתחילות להיכשל, או מחזירות משהו שסותר את הבריף, עצרו ודווחו BLOCKED.
זה מתוך קובץ האילוצים שכתבתי לפרויקט. הסכנה היא שאין כאן מצב שגיאה: אתם מבקשים node 1508:40348, מקבלים node 1508:40348, וזה הלא נכון. שום דבר בתשובה לא מרמז על כך. כתבתי על המכניקה של אותו workflow בנפרד.
לתעתק, לא לדגום
תעתקתי את הפלטה מעמוד ה-Colors של ה-style guide במקום לדגום אותה בטפטפת מתוך ה-frames. ההערה בראש ה-stylesheet שלי מתעדת את הבעיה:
/* Palette - transcribed verbatim from the Figma Style Guide "Colors" page
   (node 1424:2098). Do not invent shades; every value below is in the guide.
   Only 6 of the 51 swatches are bound to real Figma variables, so the names
   come from the swatch labels. */
שישה מתוך חמישים ואחד. זה המצב האמיתי של רוב קבצי העיצוב, והוא עדיין מקור אמת, פשוט לא כזה שמכונה יכולה לקרוא.
הכלל שאני מקפיד עליו הוא שהמצאת גוון inline היא באג. hex תועה בתוך template הוא בדיוק הדרך שבה מערכת עיצוב מפסיקה בשקט להיות מערכת.
צילום מסך הוא לא העיצוב
שני artboards של הירו היו בקובץ. אחד היה ההירו הנקי של עמוד הבית, והשני היה אותו הירו עם popup וידאו פתוח. מכיוון ש-get_screenshot ממזג שכבות canvas חופפות, צילום של השני החזיר מודאל שמכסה את העיצוב.
סמכו על עץ המטא-דאטה ועל get_design_context, לא על צילום מסך בודד. אותה סריקה תפסה גם שכבה בשם Slider שהייתה בלוק סטטי בודד ולא קרוסלה. בנייה לפי השם בלבד הייתה מייצרת פיצ'ר שלם שאף אחד לא ביקש.
אני עדיין צריך את צילום המסך, כי הוא הדבר היחיד שאומר לי באופן אמין באיזה צד יושב כל אלמנט. אבל הוא עונה על ״איפה״, לא על ״מה״.
שני frames, לא אחד
ה-frame של המובייל הוא הסמכות למובייל. הוא לא גרסה צרה של הדסקטופ, והתייחסות אליו ככזו מאבדת תוכן אמיתי: ה-frame של 360 נושא גדלים, משקלים, padding וסדר סקשנים משלו, ולפעמים גם אלמנטים שלדסקטופ אין בכלל.
כשה-frame של המובייל דרש שדה שלא היה בממשק הרכיב שלי, שיניתי את הממשק. החלופה המפתה היא להוריד את הדרישה ולרשום אותה כהערה, וזו בדיוק הדרך שבה עיצוב מובייל הופך לאט לעותק גרוע יותר של הדסקטופ.
ויש גם את הכיווניות. זה אתר RTL קבוע, והקוד ש-Figma מייצרת הוא LTR, כך שהיא תגיש לכם justify-end, items-end, text-right, left- ו-right-. כל אחד מהם הוא באג כאן, כי הם נפתרים לשמאל הוויזואלי תחת RTL. רק logical properties שורדות את התרגום, וזה מה שמאפשר ל-stylesheet אחד לשרת את שני הכיוונים.
המלכודת העדינה יותר היא מיקום ב-grid, כי תחת RTL עמודה 1 היא הימין הוויזואלי. בסקשן אחד התוכנית שלי מיקמה את ה-CTA בצד הלא נכון בדיוק מהסיבה הזו. זה נתפס כי הבנייה נבדקה מול צילום המסך ולא הוסקה מקואורדינטות ה-x של ה-frame.
איפה קובץ העיצוב טעה
התייחסות לקובץ כאמת מוחלטת פירושה שתמצאו את הטעויות שלו. זה אומר שהשיטה עובדת, לא שהמעצב נכשל. מה שחשוב הוא מה עושים ברגע הסתירה, והתשובה שלי תמיד זהה: לתעתק נאמנה, לדווח, לא לאלתר.
- פסקה שהופיעה פעמיים. פסקת הפתיחה של סקשן אחד הייתה זהה לפסקת הגוף הרביעית שלו, בשני ה-frames. בדקתי פעמיים בכל breakpoint לפני שאמרתי משהו, כי ההנחה הראשונה צריכה להיות שאני קראתי לא נכון. אחר כך בניתי את זה כפי שצויר וסימנתי.
- אייקון בלי node שניתן לפנות אליו. החץ של כרטיס אחד היה שתי שכבות, כל אחת ממוקמת ב-transform משלה, וה-MCP לא הצליח להגיע ל-override instance. אני אף פעם לא כותב ידנית path data של SVG, אז משכתי את הווקטורים הגולמיים ומיקמתי אותם מחדש לפי חשבון ה-transform מתוך הקוד ש-Figma עצמה ייצרה.
- תמונת poster שהייתה צילום מסך של נגן וידאו, כולל ממשק הנגן שנצרב בתוכה. ב-frame של המובייל הייתה תמונה נקייה, אז השתמשתי בה בשני ה-breakpoints וכתבתי למה.
מה לא תיקנתי
תשעה כרטיסי מידע יצאו עם href ריק כי לא היו יעדים בשום מקום: לא ב-frame, לא בבריף ולא באתר הישן. להמציא קישורים היה גרוע יותר מלהשאיר אותם מנוטרלים. זו החלטת תוכן שממתינה למשרד, והיא רשומה ככזו.
הלולאה שאפשרה את זה
כללי ה-Figma למעלה הם הטכניקה. מה שהפך בנייה מחדש של 638 קומיטים לאפשרית לאדם אחד הוא שכל סקשן עבר את אותם ארבעה שלבים:
- בריף כתוב שנקב ב-node של Figma ובאילוצים שלו.
- בנייה מול אותו בריף.
- ביקורת עצמאית מול ה-diff, לא מול התיאור שלי של ה-diff.
- דוח כתוב שתיעד מה סטה, ולמה.
אני רוצה לדייק איך זה התאפשר, כי התשובה היא לא שאני מקליד מהר. הרצתי את הפרויקט עם Claude Code.
הגרסה הכנה של אותה טענה צרה יותר מגרסת השיווק: ה-AI לא עיצב את האתר, והוא לא החליט שום דבר משמעותי. מה שהוא שינה זה המחיר של עבודה בצעדים קטנים שכל אחד מהם מאומת בנפרד.
בריף, בנייה וביקורת הם לולאה איטית כשאדם אחד עושה את שלושתם. היא מהירה מספיק כדי לרוץ 638 פעמים כשסוכן מנסח טיוטה לכל שלב ואני בודק את ה-diff.
המשמעת היא העיקר, לא המהירות. סוכן יבנה בשמחה כל מה שתתארו, ולכן הבריף הוא המקום שבו אתם מגלים שמה שתיארתם הוא לא מה שרציתם, בזמן שהגילוי עוד זול.
כתבתי על איפה זה עוזר ואיפה זה נשבר בוורדפרס, וגם על שרתי ה-MCP שמחברים את זה לכלים אמיתיים.
שנים עשר בריפים, שנים עשר דוחות, ו-diff של ביקורת שמור לכל משימה. לפני כל commit, שני ה-linters היו חייבים להיות באפס, לא הייתה שום הודעת PHP, והרינדור היה חייב להתאים ל-frames בשני הרוחבים.
מזהי node יושבים בהערות הקוד ובכותרות הקומיטים, כך שכל שורת CSS ניתנת למעקב חזרה עד ל-frame:
f6f2307Build the practice-area cards from the 1920 and 360 comps (Figma 1508:40324)
הלולאה שווה משהו רק כי היא מתעדת איפה היא נכשלת. היא תיעדה עצירה מוחלטת כשהגשר ל-Figma הפך לבלתי נגיש, במקום לתת לי למלא את החור בשקט מהזיכרון. היא גם תיעדה ממצא ביקורת שהתברר כ-false positive, שאותו עקבתי חזרה לטעות בבריף שלי עצמי.
מגבלה אחת בכנות: אין כאן מפת Code Connect. מזהי node בהודעות קומיט הם גרסה ידנית של מה ש-Code Connect עושה כמו שצריך, ובמערכת עיצוב שרצה לאורך זמן זו הייתה התשובה הטובה יותר.
מה שיצא זו תבנית Tailwind v4: CSS-first, בלי קובץ config. stylesheet אחד במשקל 24 KB gzipped משרת את כל האתר, כולל ה-layout מימין לשמאל, בלי build נפרד ל-RTL. התבנית הישנה שלחה תשעה stylesheets במשקל כולל של 203 KB, אחד מהם Bootstrap. את פרטי ההתקנה שמתי בפוסט שלי על Tailwind v4.
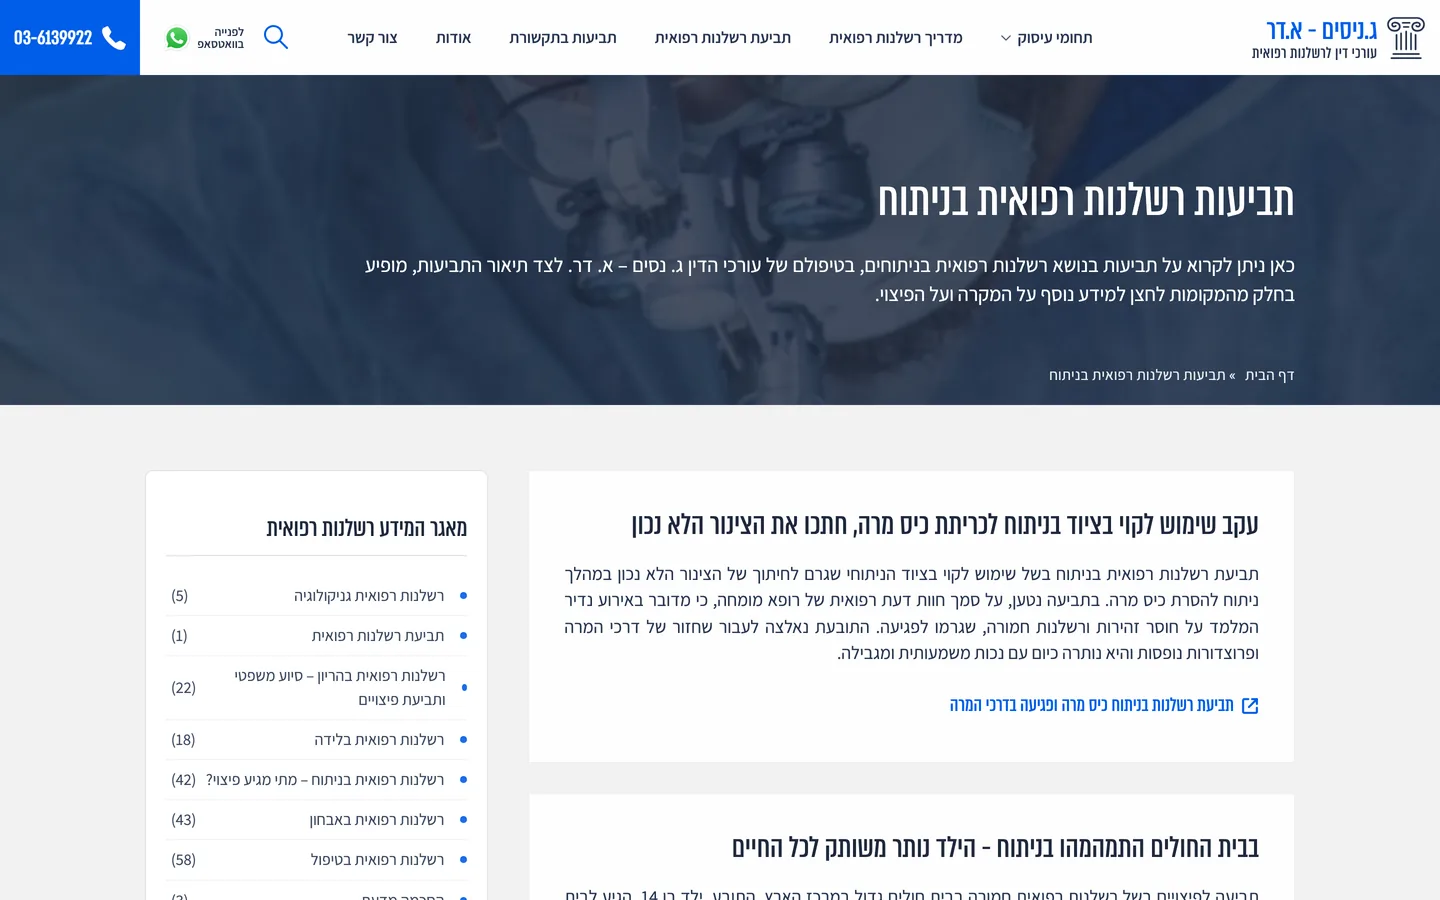
 לפניאחרי
להעביר 301 מאמרים שלא היה בהם מאמר
החלק הקשה לא היה הכמות, אלא שב-301 פוסטים לא היה אפילו שדה יחיד בבסיס הנתונים שהחזיק מאמר גמור.
ל-143 פוסטים היה post_content ריק לחלוטין. לעוד 158 היה post_content שמעולם לא רונדר, כי הוא הוחלף שנים קודם לכן. המאמר האמיתי ישב בשדה flexible content של ACF עם 16 סוגי layout, והורכב בזמן הרינדור.
ייצוא מבסיס הנתונים היה נותן לי 143 עמודים ריקים ו-158 עמודים שגויים. אז התייחסתי ל-frontend המרונדר כמקור האמת: למשוך כל מאמר כ-HTML, לפרסר אותו, ולבנות אותו מחדש בתוך התבניות החדשות.
זה שביר יותר מייצוא בסיס נתונים, וזו בדיוק הסיבה שהייתי חייב לאמת את זה אחרת. עשיתי diff לכל פוסט מול המקור שלו, מילה במילה: 0 מילים אבדו, 0 מילים הומצאו, על פני כל 301 הפוסטים. שלב האימות הזה הוא לב העניין בכל העברה של ארכיון תוכן שאני עושה.
| מה הועבר | כמות |
|---|---|
| פוסטים | 301 מתוך 301 |
| תמונות ראשיות | 278 ייחודיות, על פני 299 פוסטים |
| ערכי מטא של Yoast | 1,995 |
| קישורים שנשמרו | 1,738 |
| סיפורי הצלחה | 88 מתוך 88 |
שלושה באגים שרק ה-diff תפס
- 284 הערות HTML מוסתרות שנשארו מ-Google Docs. בלתי נראות בעמוד, ונגררות בשמחה בכל העתקה נאיבית.
- מאפייני
dirו-langשנמחקו כאילו היו עיצוב. באתר בעברית הם סמנטיים: הם מה שגורם לביטוי אנגלי משובץ או למספר טלפון להיות מוצג בסדר הנכון. - שתי מילים שהתמזגו בשקט. המפריד במקור היה
<span dir="LTR"> </span>, שנראה לפרסר כמו רווח ופשוט נעלם.
כל השלושה היו יוצאים לאוויר בשקט. בדיקה ברמת העמוד או בדיקת ספירת תווים עוברת את כולם. אם אתם מעבירים תוכן על ידי scraping, ה-diff ברמת המילה הוא לא מותרות. הוא הדבר היחיד שעומד ביניכם לבין ארכיון תוכן ששגוי בעדינות ב-301 מקומות.
לשמור על הכתובות
בנייה מחדש היא המקום שבו כוח הקישורים מת. עשרים שנות מאמרים צוברות קישורים נכנסים, ומבנה כתובות חדש זורק אותם בשקט: העמודים עדיין עובדים, הדירוגים לא.
אז שמרתי כל כתובת שהייתה קיימת והפניתי רק את מה שלא יכול היה לשרוד. סיפורי ההצלחה היו המקרה המעניין. באתר הישן הם היו פוסטים רגילים; היום הם custom post type עם ארכיון מסונן. אותו slug, אותה כתובת, אובייקט אחר, בלי הפניה, כי שום דבר לא זז.
 לפניאחרי
68 כללי הפניה חיים, כולם 301, אף אחד מהם לא regex, והם תפסו 738 בקשות בחודש הראשון. הקבוצות הגדולות הן שני סוגי תוכן שהוצאו משימוש: 23 כללים לעמודי וידאו ישנים ו-8 לעמודי שאלות ותשובות ישנים.
מה שאני הכי אוהב הוא הכללים עם שגיאות הכתיב. בערך 21 מהם מפנים מכתובות בעברית שהיו מאויתות שגוי באתר הישן, וצברו קישורים נכנסים אמיתיים בכל זאת. לשמר שגיאת כתיב מרגיש לא נכון, אבל זה נכון: הקישור קיים, התנועה אמיתית, ואף אחד שקישר לשם לא הולך לתקן אצלו.
כיביתי גם את ניחוש הכתובות של וורדפרס, שמפנה בשקט ב-301 כתובת לא מוכרת לפוסט שיש לו slug דומה. היום כתובת שלא קיימת מחזירה 404, כך שאני יכול לראות אותה ולתקן. מה באמת גורם לאותן שגיאות 404 זה פוסט בפני עצמו.
נתי אלימלך עבר על ה-SEO בסביבת הבדיקה ומצא שלושה דברים ששווה להזכיר:
- ה-H1 בעמוד הבית ישב על הסלוגן במקום על הביטוי שעליו המשרד באמת מדורג.
- לנתונים המובנים היה
Organizationעם שם ולוגו, אבל בלי כתובת, טלפון או שעות פעילות. - אותו ניחוש כתובות עדיין היה דלוק.
שלושתם תוקנו באתר החי.
ביצועים
השיפור הגיע כמעט כולו מהסרה של דברים שהעמוד מעולם לא השתמש בהם. אין שום טריק חכם שמסתתר בסקשן הזה.
| עמוד הבית, מובייל | ישן | חדש |
|---|---|---|
| סך הכל הועבר | 2,576 KB | 430 KB |
| בקשות | 125 | 32 |
| סקריפטים | 29 קבצים, 1,580 KB | 3 קבצים, 200 KB |
| צד שלישי | 59 בקשות, 1,549 KB | 5 בקשות, 201 KB |
| תמונות | 47 קבצים, 790 KB | 20 קבצים, 121 KB |
| Largest Contentful Paint | 18.20 שניות | 2.77 שניות |
| Total Blocking Time | 270 ms | 1 ms |
השורה הגדולה ביותר היא סקריפטים של צד שלישי: 1.5 MB של tag manager, אנליטיקס ופיקסלים בגרסה הישנה, מול 201 KB היום. רוב מה שמאט אתר וורדפרס הוא בדרך כלל לא וורדפרס.
הסרה אחת הייתה קשה יותר ממה שהיא נראית. Dashicons שקל 36 KB gzipped וחסם רינדור, ונגרר על ידי תוסף עבור widget שהאתר לא משתמש בו.
התיקון הראשון שלי עשה dequeue והפסיד במרוץ מול האינטגרציה של תוסף ה-cache עם הטפסים, שהחזירה אותו. הגרסה שעובדת מסננת את תגית ה-stylesheet בזמן ההדפסה, וזו הדרך האמינה להסיר CSS שתוסף מתעקש לטעון.
השאר רגיל: תמונות הירו ב-AVIF עם preloads ממוקדי media, ספריית הקרוסלה נטענת רק כשקרוסלה מתקרבת ל-viewport, וידאו של 1.6 MB שלא נדרש בטלפונים, והאנליטיקס שהוצא מה-head כדי שיפסיק לגבור על תמונת ההירו בעדיפות.
אותם שני עמודים, הפעם לפי הציון של גוגל
אלה המספרים שלי, מהמכונה שלי. אלה המספרים של גוגל: העברתי את שני עמודי הבית ב-PageSpeed Insights ב-1 באוקטובר 2026, בהפרש של שלוש דקות, על אותו Moto G Power מדומה ברשת 4G איטית.
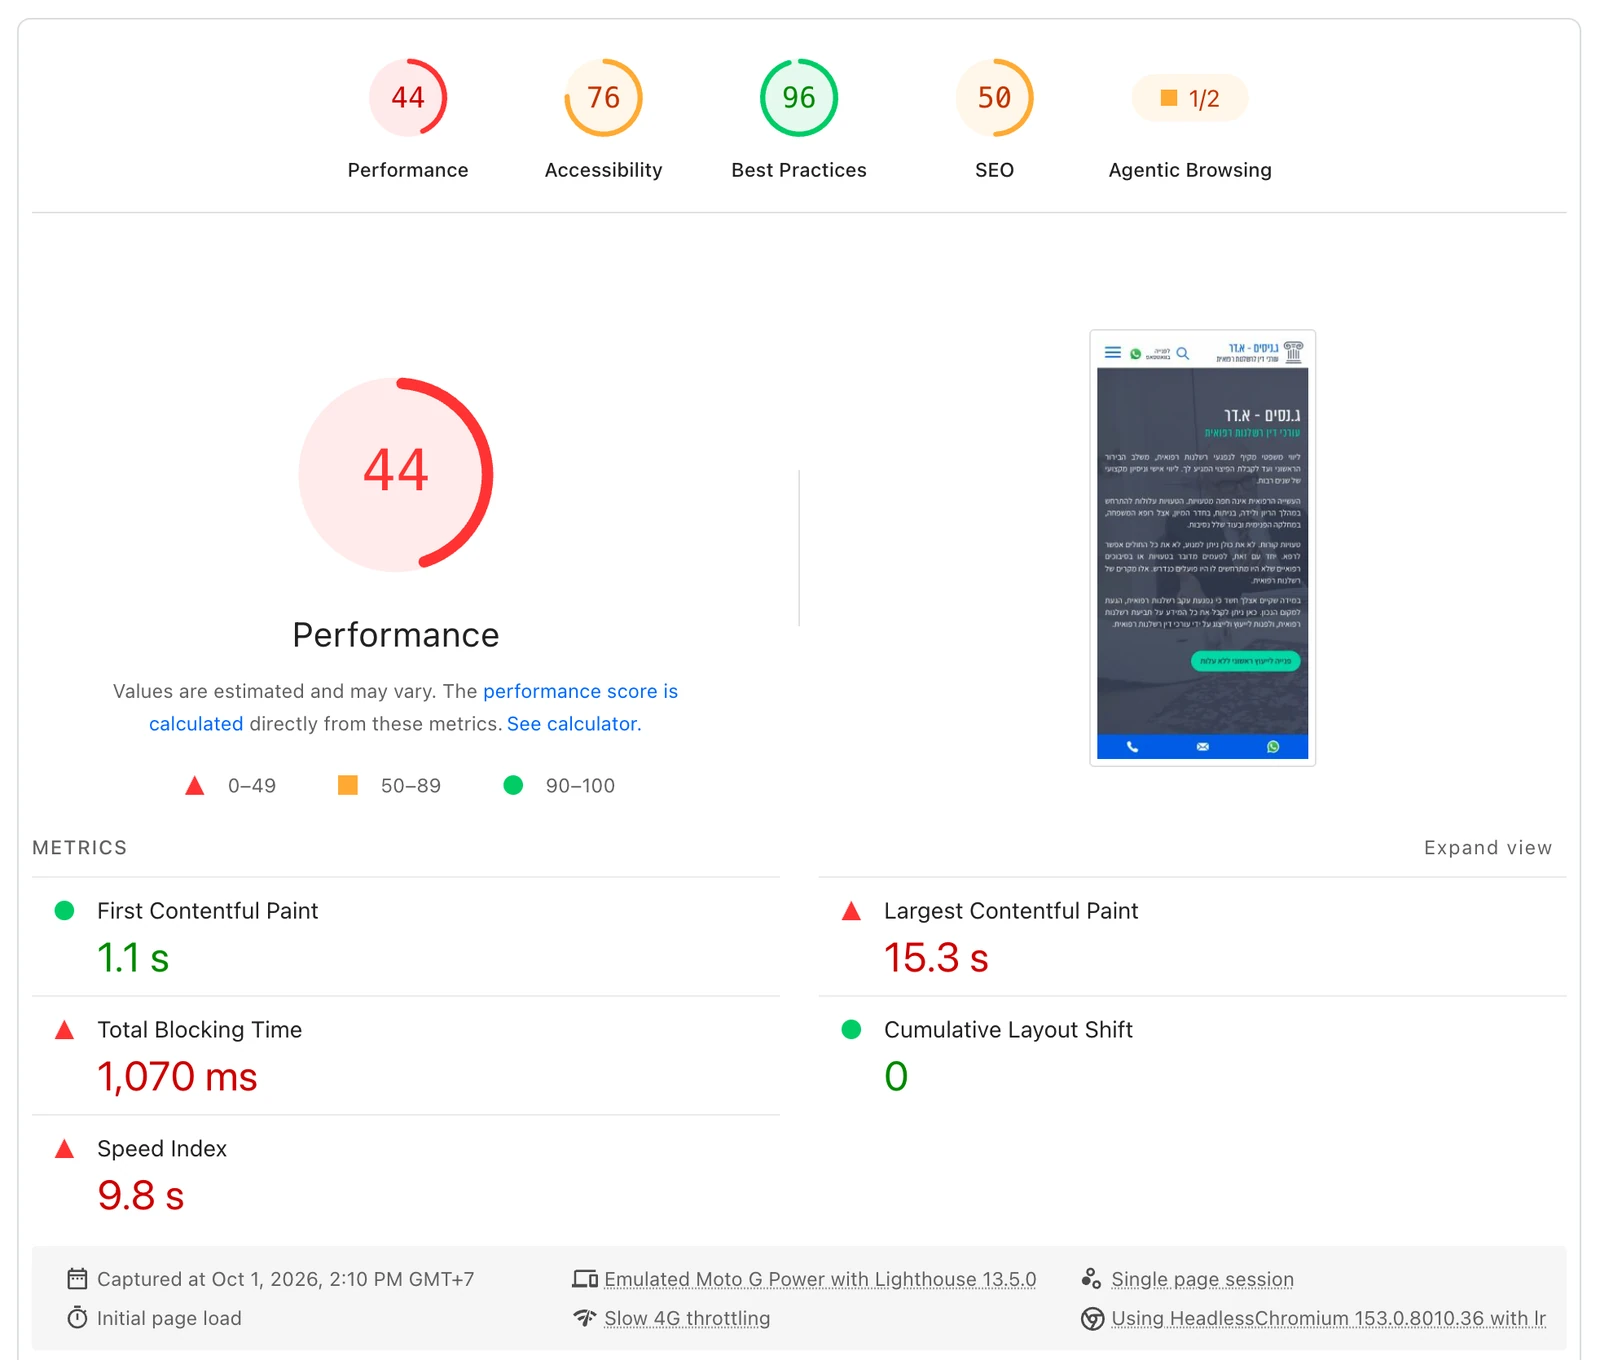
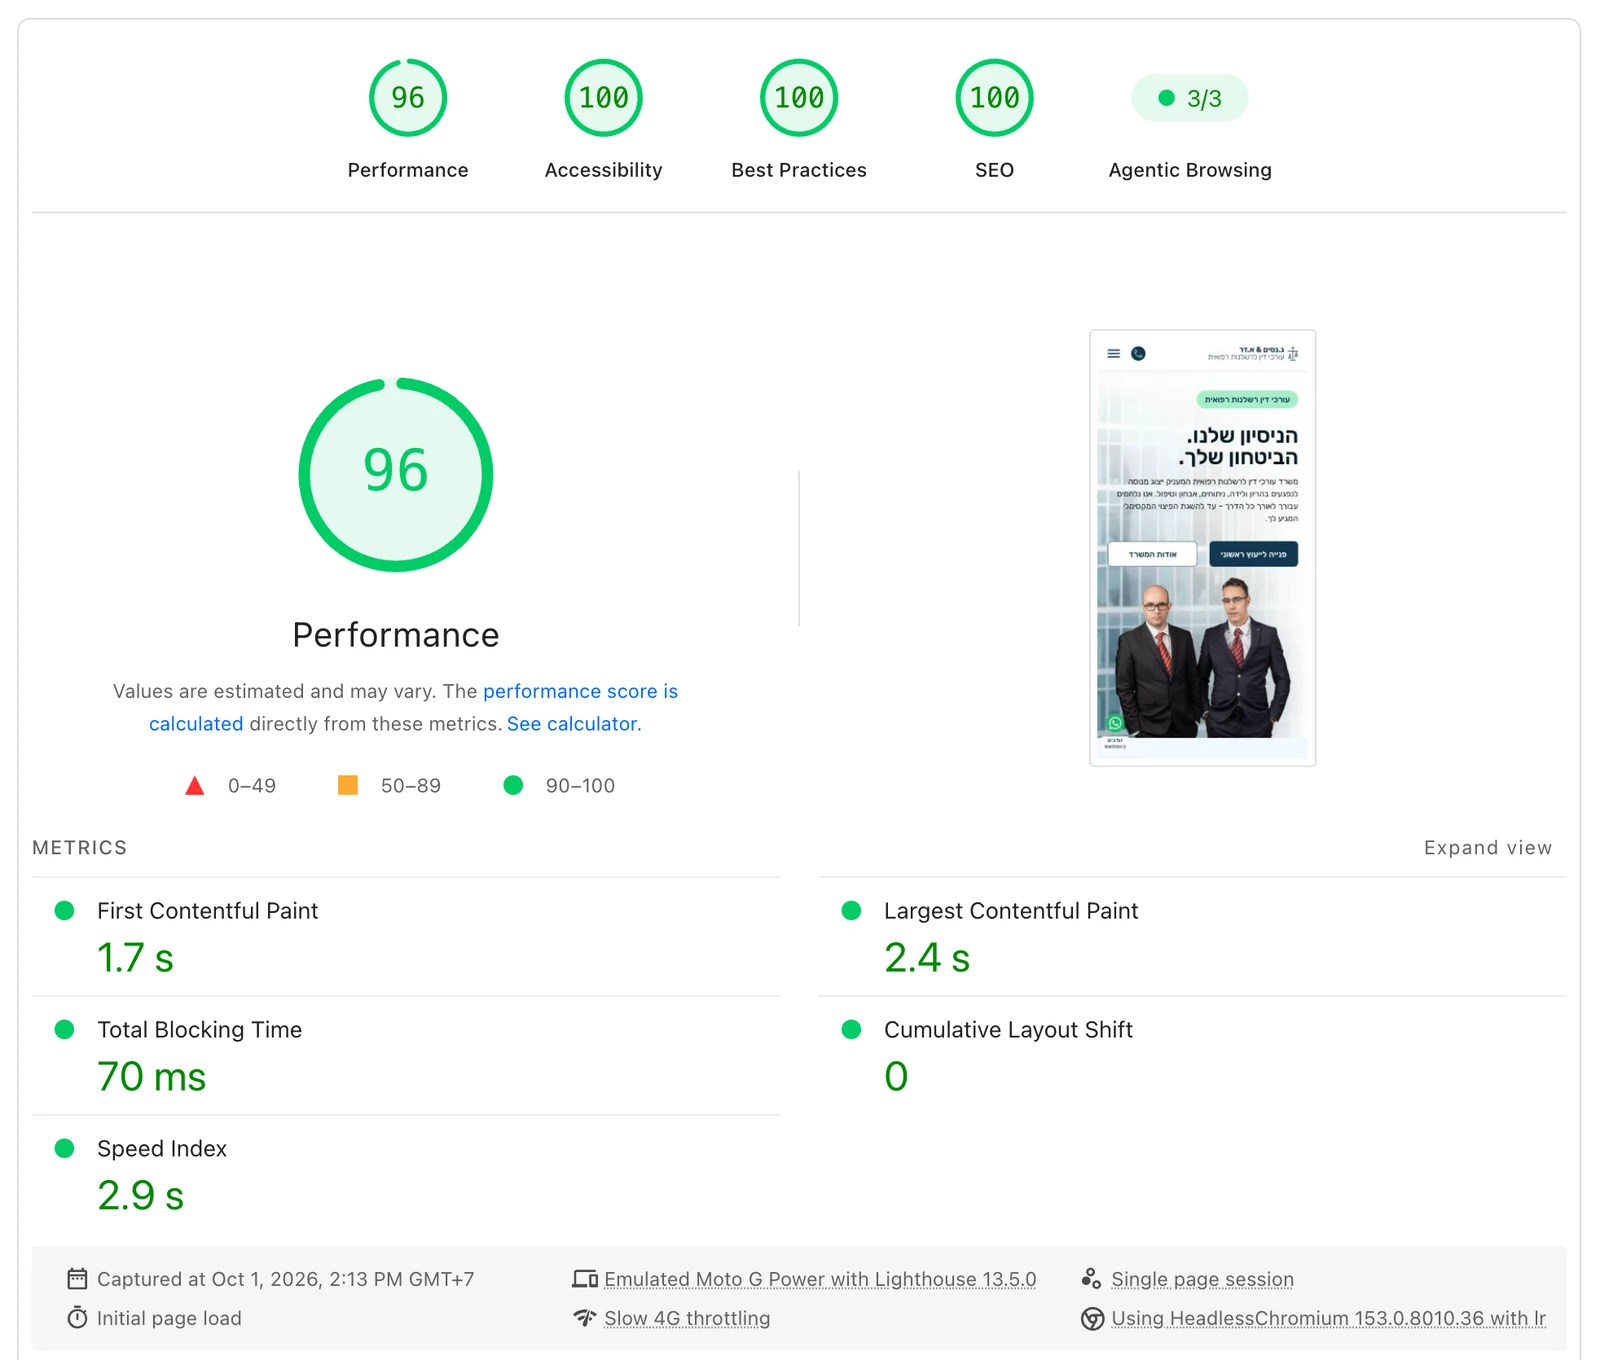
מספר אחד זז בכיוון הלא נכון. First Contentful Paint עלה מ-1.1 שניות ל-1.7 שניות. העמוד הישן הציג טקסט על המסך מוקדם, ואז לקח לו עוד ארבע עשרה שניות להגיע לאלמנט הגדול שלו; החדש מצייר פעם אחת, ב-1.7 שניות, ומסיים ב-2.4.
שתי הרצות מעבדה עם תוצאות לא תואמות: Lighthouse המקומי שלי נתן לעמוד הבית הישן 58, PageSpeed Insights נתן לו 44. אותה בנייה, אבל חומרה ופרופיל רשת אחרים. פער זה הוא בדיוק הסיבה להתייחס לכל ציון בודד כראיה חלשה ולקרוא את המגמה במקום. בנוסף, אף אחד מהם אינו דוח Core Web Vitals, ולכן נתוני השדה ב-Search Console נשארים מקור האמת למה שגולשים ישראלים באמת חווים.
שלב הדיפלוי שמסרב לרוץ
שלוש התקנות וורדפרס חיות זו לצד זו על השרת הזה. נתיב דיפלוי שגוי לא היה מתריע. הוא היה מעתיק בשקט את התבנית הזו על אתר של מישהו אחר ואז מנקה לו את ה-cache.
אז לפני שהדיפלוי שלי כותב משהו, הוא בודק איפה הוא נחת:
- name: Verify the target application before writing anything
  # Three WordPress installs live side by side. A wrong DEPLOY_PATH would not
  # fail, it would quietly deploy the gnlaw theme over somebody else's site
  # and then flush their caches.
  run: |
    test -f "$DEPLOY_PATH/wp-config.php"
    test ! -d "$DEPLOY_PATH/wp-content/themes/sevenis"
    test "$(wp option get home --path=$DEPLOY_PATH)" = "$EXPECTED_HOME_HOST"
ה-workflow הוא GitHub Actions. push ל-main בונה ומסנכרן את התבנית ב-rsync, ואז מנקה שלוש שכבות cache לפי הסדר, כי הן מקוננות. 385 הרצות עד כה, שלוש נפילות, ודיפלוי ירוק בכ-40 שניות.
פקודת ה-CLI של תוסף ה-cache לא נוגעת בקבצים המוקטנים. גיליתי את זה בדרך הקשה, כשסקריפט שנכתב מחדש עלה כמו שצריך והעמוד המשיך להריץ את הגרסה הקודמת, בלי ששום דבר בלוג נראה חריג. כתבתי על מלכודות ה-CI/CD וניקוי ה-cache בנפרד.
מה השתבש
ארבעה דברים, כי תיק עבודות שבו שום דבר לא השתבש הוא ברושור.
מדדתי מהיבשת הלא נכונה, שלוש פעמים
דיווחתי על זמן הבייט הראשון של המקור כבעיה, תיקנתי, דיווחתי שוב, ותיקנתי שוב. כל שלוש הגרסאות היו שגויות מאותה סיבה: כל מדידה בוצעה מנקודת יציאה לרשת בתאילנד ולא מישראל.
מה שסגר את זה היה ביקורת. זמן ההתחברות למקור של האתר היה 0.261 שניות; לשרת ישראלי לא קשור מאותו מקום, 0.264 שניות. שלוש אלפיות שנייה הפרש. לא הייתה בעיה במקור, רק מדידה שבוצעה 7,000 ק״מ מהקהל. שווה להבין את TTFB לעומק לפני שפועלים לפי קריאה שלו.
שתי הגרסאות שנפסלו עדיין נמצאות במסמך הביקורת, כי ביקורת שמוחקת בשקט את הטעויות של עצמה היא לא ביקורת.
מחקתי אתר בהעתקה ידנית של drop-in של cache
בשלב מוקדם העתקתי התקנה של Object Cache Pro מאתר אחר לסביבת הבדיקה. זה חיבר את Redis באמצע ההתקנה, קריאת options ישנה שמרה רשימת תוספים פעילים שבורה לבסיס הנתונים, והאתר חזר עם תבנית ברירת המחדל וכל התוספים לכאורה מנוטרלים.
המידע היה שלם, כי זו הייתה תקלת קוהרנטיות של cache ולא אובדן, אבל רשימת התוספים המדויקת שלפני האירוע נעלמה והייתי צריך לשחזר אותה. זה קרה בסביבת הבדיקה, לפני העלייה לאוויר, וזו הסיבה היחידה שזו פסקה ולא סיפור הרבה יותר גרוע.
שניים קטנים יותר
- ה-workflow של הדיפלוי שלי עדיין נקרא ״staging״. היעד הוא production מאז העלייה לאוויר. שינוי שם מאפס את היסטוריית ההרצות והשומר על היעד כבר אוכף את ה-host הנכון, אז זה נשאר. זה עדיין מבלבל את מי שקורא את זה אחר כך.
- האנליטיקס מלפני העלייה לאוויר כולל את התנועה שלי. העותק המקומי שלי דיווח צפיות בעמוד לנכס החי כ-sessions אמיתיים עד שהוספתי שומר host. זו הסיבה שתיק העבודות הזה לא מצטט שום נתון אנליטיקס: הדבר הכן היחיד שאפשר לעשות עם טווח תאריכים מזוהם הוא לא לצטט ממנו.
איפה זה נחת
למשרד יש אתר שנטען בחמישית מהמשקל, כולל את כל 301 המאמרים עם כל מילה שלמה, עונה על כל כתובת שאי פעם פרסם, וניתן לעריכה על ידי האנשים שהוא שייך להם.
מה שלא גמור רשום:
- 97 כותרות עמוד חורגות מ-70 תווים, בירושה מתבנית כותרות שעברה יחד עם המיגרציה.
- לתשעה כרטיסי מידע עדיין אין יעדים.
- עמוד תחום התמחות אחד שולח 288 KB של HTML כי הוא נושא 87 תמונות בגוף שלו, וזו החלטת תוכן ולא החלטת תבנית.
מה שאפשר את זה לא היה מהירות. זה היה שהעיצוב היה מקור אמת קריא ולא תמונה, שכל שורת CSS ניתנת למעקב חזרה עד מזהה node, ושלכל סקשן היה בריף כתוב וביקורת עצמאית לפני שנתתי לו להיחשב גמור.
שובל הביקורת הזה הוא לא עלות מיותרת. הוא החלק שהופך את העבודה לניתנת לבדיקה בעוד שנה, בנקודה שבה כבר לא אזכור למה ל-frame של המובייל היה כפתור נוסף.
אם זו הבנייה שאתם צריכים, עמוד השירות של Figma ל-WordPress מתאר אותה, והבנייה מחדש של 7is היא אותה שיטה על אתר דו-לשוני בקנה מידה קטן יותר.